
Day8 拆完 AGENTS.md:它會被整份塞進 system prompt,每一輪都跟著送出去。這代表一件事——它有成本上限。
專案規則寫個二三十行沒問題。但如果你想把「資料遷移的完整六步驟」「發版流程」「怎麼寫 migration 檔」全部寫進去,這份檔案會膨脹成幾千個 token,而且每一輪都在付這筆錢,即使今天的任務根本不碰資料遷移。
Skills 就是為了解決這件事。
一個 skill 就是一個資料夾,裡面有一個 SKILL.md:
taskapp-migration/
└── SKILL.md
SKILL.md 的開頭是 frontmatter,只有兩個必填欄位:
---
name: taskapp-migration
description: Required procedure for any change to taskapp data models ... Use whenever a task changes a taskapp model or asks for a data migration.
---

# taskapp model change and migration

1. schema/models.json — 加欄位、version +1
2. python scripts/gen_models.py
...
description 是整個機制的關鍵,等一下會說為什麼。
Pi 會從這些地方找 skills:全域的 ~/.pi/agent/skills/、~/.agents/skills/;專案的 .pi/skills/、.agents/skills/(這兩個要專案被信任才會載入);npm 套件;設定檔;還有 CLI 的 --skill 參數。量測台用的是 --skill,因為它不受專案信任影響,也不會污染我電腦上的全域設定。
這是 progressive disclosure 的核心。Pi 不會把 SKILL.md 的內容放進 system prompt,只放名稱、描述、檔案位置:
// dist/core/skills.js(節錄)
const lines = [
    "\n\nThe following skills provide specialized instructions for specific tasks.",
    "Use the read tool to load a skill's file when the task matches its description.",
    "When a skill file references a relative path, resolve it against the skill directory ...",
    "",
    "<available_skills>",
];
for (const skill of visibleSkills) {
    lines.push("  <skill>");
    lines.push(`    <name>${escapeXml(skill.name)}</name>`);
    lines.push(`    <description>${escapeXml(skill.description)}</description>`);
    lines.push(`    <location>${escapeXml(skill.filePath)}</location>`);
    lines.push("  </skill>");
}
所以流程是這樣的:
read 工具把那份 SKILL.md 讀進來。這跟 AGENTS.md 的「不管用不用到,每輪都送」形成對比。你可以掛二十個 skill,平常只付二十段描述的錢。
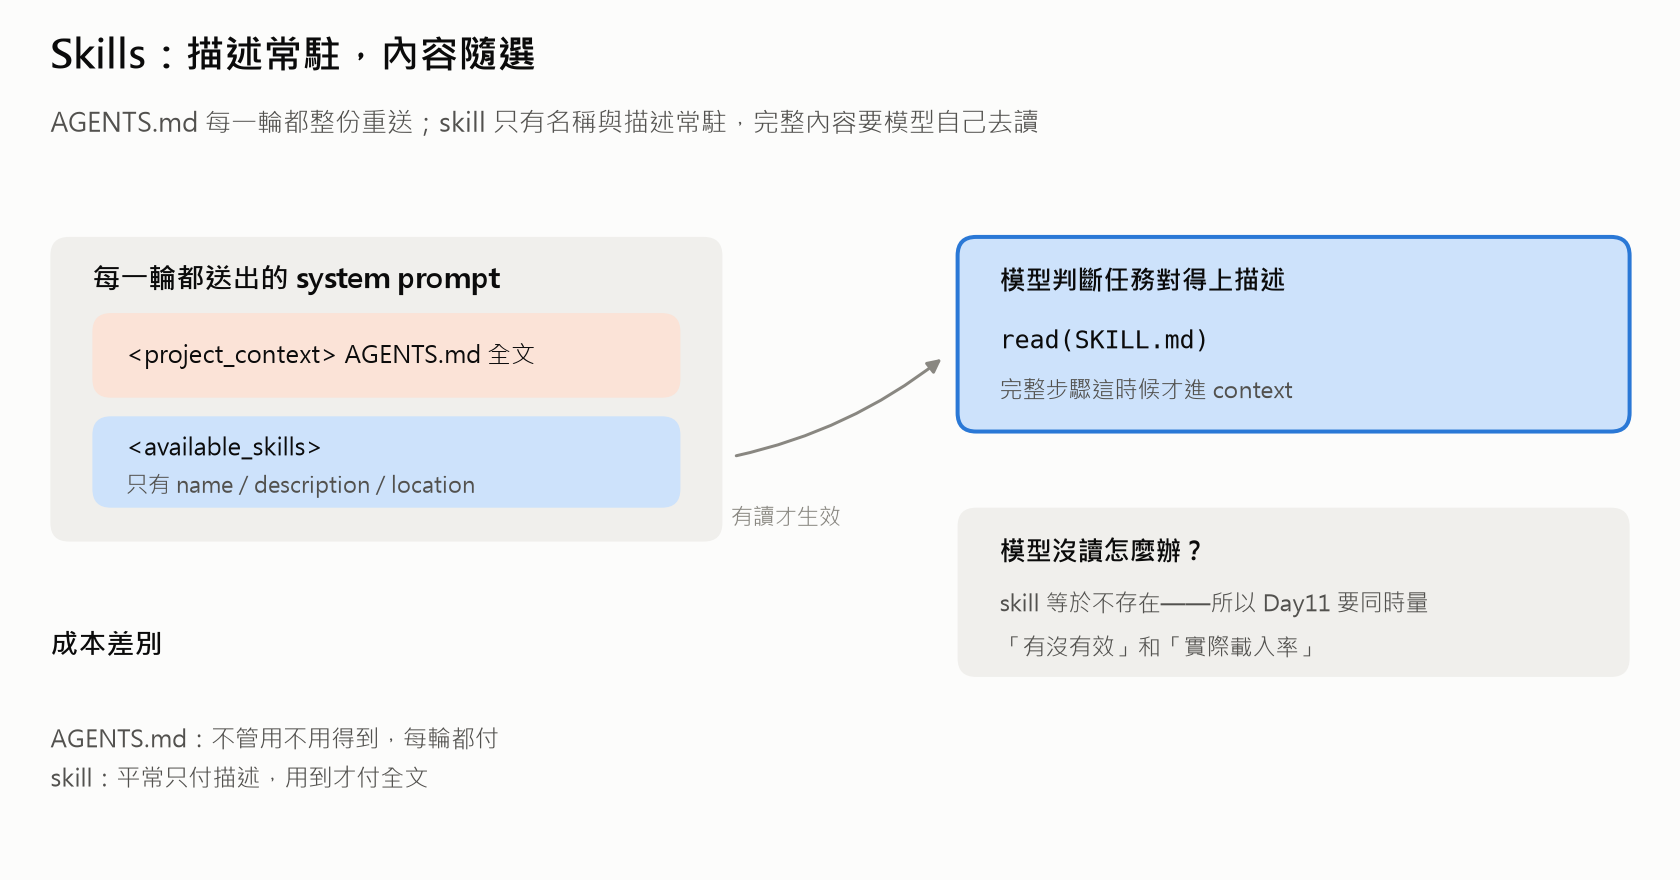
還有一個容易忽略的細節:skills 只有在 read 工具開著的時候才會被放進 system prompt。原始碼裡是這樣寫的:
if (hasRead && skills.length > 0) {
    prompt += formatSkillsForPrompt(skills);
}
道理很直接——沒有 read 工具,模型根本沒辦法把 skill 讀進來,放描述進去只是浪費 token。這也是一個小小的 harness 設計範例:能力不存在時,不要在 prompt 裡提到它。
progressive disclosure 省 token 的代價是:模型必須自己決定要不要讀。Pi 官方文件對這件事講得很坦白,說模型「不見得總是會這樣做」,必要時得靠 prompt 或 /skill:name 指令強迫它載入。
這就出現一個 AGENTS.md 不會有的失敗模式:
AGENTS.md 的規則:一定在模型眼前,模型可能無視,但不會「沒看到」。所以 skill 的 description 不只是文件,它是觸發條件。寫「處理資料相關的事情」這種描述,模型很難判斷什麼時候該用;寫成「任何會改到 taskapp 資料模型的變更,或要求寫資料遷移時使用」,命中率才會高。
因為有「可能沒被讀」這個失敗模式,Day11 的實驗要同時量兩件事,而不是只看成功率:
read 那份 SKILL.md 的比例有多高。第二個數字是關鍵。如果掛了 skill 但成功率沒變,有兩種完全不同的解釋:模型讀了但沒用,或是模型根本沒讀。分不清楚這兩件事,就會把「description 寫得不好」誤判成「skill 這個機制沒用」。量測台從 session 記錄裡撈出每一次 read 的路徑,就是為了回答這個問題。
兩組實驗都會拿掉 AGENTS.md,而且兩組專案裡的 docs/migrations.md 都留著——差別只有「有沒有那份 skill」這一個變數。
Day11 公布數字:Skills 開跟關差多少,以及模型到底有沒有真的去讀那份 SKILL.md。


 iThome鐵人賽
 看影片追技術